AI Inference Engine Optimization Dorong Era On-Device AI yang Lebih Cepat dan Efisien

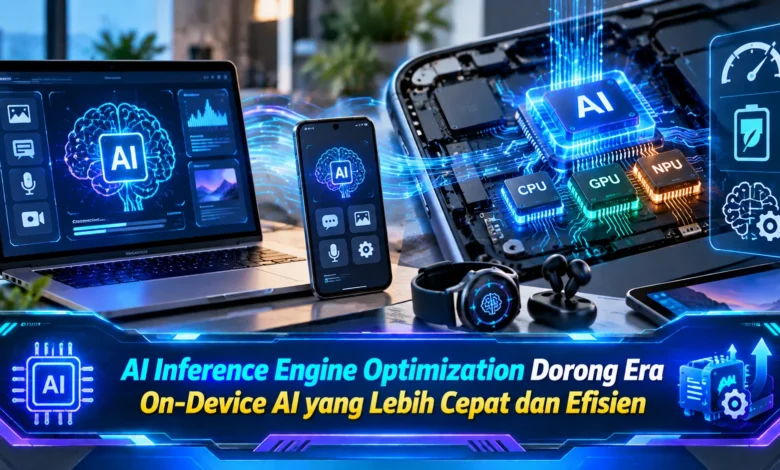
Perkembangan AI mulai bergerak semakin dekat ke perangkat pengguna melalui konsep on device AI. Smartphone, laptop, wearable, kendaraan, dan berbagai perangkat pintar kini membutuhkan kemampuan menjalankan model kecerdasan buatan secara cepat tanpa selalu bergantung pada pemrosesan cloud. AI Inference Engine Optimization menjadi bagian penting dalam perubahan tersebut karena teknologi ini membantu model memanfaatkan CPU, GPU, NPU, memori, dan sumber daya perangkat secara lebih efisien sehingga pengalaman AI lokal dapat terasa semakin responsif.
On Device AI Membutuhkan Inference Engine yang Semakin Efisien
AI Inference Engine Optimization bekerja dengan mengatur proses eksekusi model agar dapat memanfaatkan kemampuan perangkat secara lebih efektif. Ketika proses pelatihan model telah selesai, perangkat menggunakan inference untuk memproses input baru dan memberikan hasil yang sesuai. Proses ini dapat membutuhkan sejumlah besar perhitungan sehingga kekuatan prosesor perlu didukung optimalisasi software yang tepat.
Untuk on device AI, optimalisasi memiliki peran besar sebab perangkat lokal mempunyai batas konsumsi energi, kapasitas memori, temperatur, serta performa hardware. Inference engine dapat menganalisis struktur model, memilih operasi yang sesuai, menentukan penggunaan accelerator, dan mengurangi proses yang tidak diperlukan. Cara tersebut membuat teknologi AI pada perangkat dipengaruhi bukan hanya oleh kekuatan prosesor, tetapi juga kemampuan software mengoptimalkan sumber daya yang tersedia.
Inference Engine Mengatur Pembagian Workload pada Hardware
Perangkat modern dapat memiliki beberapa jenis unit pemrosesan dengan karakteristik yang berbeda. CPU menawarkan fleksibilitas untuk menangani berbagai instruksi umum, GPU memiliki kemampuan menjalankan banyak operasi secara paralel, sedangkan NPU dirancang untuk mempercepat workload AI tertentu secara efisien. Karakteristik tersebut membuat sistem inference dapat menentukan hardware yang cocok untuk setiap bagian workload.
Penjadwalan pekerjaan yang efisien dapat mencegah seluruh operasi inference bergantung hanya pada satu unit komputasi. Pekerjaan serbaguna dapat menggunakan CPU, operasi paralel dapat diberikan kepada GPU, sedangkan komputasi AI tertentu dapat memanfaatkan NPU. Mesin inference tetap harus memperhitungkan perpindahan informasi antarprosesor karena distribusi workload yang berlebihan dapat menambah overhead. Dengan pembagian yang terencana, teknologi on device AI dapat memperoleh manfaat dari berbagai accelerator tanpa mengorbankan efisiensi secara berlebihan.
Optimalisasi Graph Membantu Model AI Berjalan Lebih Ringkas
Model AI dapat direpresentasikan sebagai rangkaian operasi komputasi yang saling terhubung sehingga membentuk computational graph. Inference engine dapat menganalisis struktur tersebut untuk mencari bagian yang dapat disederhanakan, digabungkan, atau dieksekusi dengan metode yang lebih efisien. Langkah ini dilakukan untuk menekan proses tambahan tanpa menghilangkan fungsi yang diperlukan oleh model.
Operator fusion dapat digunakan untuk menggabungkan beberapa tahap komputasi sehingga eksekusinya tidak harus dilakukan secara terpisah. Penggabungan tersebut dapat mengurangi kebutuhan membaca serta menulis data secara berulang ke memori. Apabila proses tambahan serta transfer informasi dapat ditekan, CPU, GPU, dan NPU dapat memusatkan lebih banyak sumber daya pada workload utama. Optimalisasi seperti ini membantu teknologi on device AI menghasilkan respons lebih cepat tanpa selalu membutuhkan peningkatan besar pada spesifikasi perangkat keras.
Quantization Membuat Model AI Lebih Ringan untuk Perangkat Lokal
Quantization menjadi salah satu teknik penting karena model AI dapat menggunakan banyak parameter serta operasi numerik selama inference. Penggunaan presisi yang lebih rendah pada operasi yang sesuai dapat membantu menekan konsumsi memori dan kebutuhan pemrosesan. Ukuran representasi yang lebih ringkas memungkinkan perpindahan informasi menggunakan bandwidth memori secara lebih efisien.
Manfaat quantization dapat semakin besar ketika CPU, GPU, atau NPU memiliki dukungan terhadap format numerik yang digunakan. Meski dapat meningkatkan efisiensi, tingkat quantization harus diuji sebab penurunan presisi yang berlebihan dapat memengaruhi hasil. Mesin inference perlu menyeimbangkan kecepatan pemrosesan, ukuran model, penggunaan memori, konsumsi energi, serta ketepatan hasil. Pertimbangan tersebut penting bagi teknologi AI lokal karena perangkat harus menjalankan model secara cepat sambil mempertahankan efisiensi baterai.
AI Lokal Membutuhkan Keseimbangan Performa dan Konsumsi Energi
Kemampuan prosesor saja belum cukup untuk menentukan performa AI lokal sebab perpindahan data dari memori menuju unit komputasi juga menjadi bagian penting. Unit pemrosesan yang cepat tetap dapat kehilangan efisiensi ketika harus menunggu data maupun parameter tersedia. Oleh sebab itu, mesin inference dapat mengatur buffer, merencanakan alokasi, menentukan urutan komputasi, dan menggunakan kembali memori sementara.
Penggunaan energi menjadi faktor penting sebab workload AI yang berjalan dalam waktu lama dapat meningkatkan konsumsi baterai dan temperatur. Sistem dapat memilih unit pemrosesan berdasarkan kebutuhan serta mengelola workload agar hardware tidak bekerja terlalu berat untuk tugas yang sebenarnya ringan. Cara tersebut membantu teknologi AI lokal diterapkan pada ponsel, komputer portabel, wearable, serta perangkat pintar yang membutuhkan keseimbangan performa dan efisiensi energi.
Optimalisasi Inference Mempercepat Perkembangan On Device AI
AI Inference Engine Optimization menjadi salah satu fondasi penting dalam perkembangan on device AI karena model kecerdasan buatan perlu berjalan cepat dengan sumber daya perangkat yang terbatas. Distribusi pekerjaan pada CPU, GPU, dan NPU memungkinkan hardware digunakan berdasarkan kekuatannya, sementara optimalisasi graph dan penggabungan operator membantu menekan overhead. Quantization membantu menekan ukuran serta kebutuhan komputasi model, sementara optimalisasi memori mengurangi hambatan dalam perpindahan informasi. Apabila berbagai optimalisasi tersebut berjalan bersama pengaturan energi yang tepat, teknologi on device AI dapat memberikan respons lebih cepat dengan penggunaan sumber daya yang lebih terkontrol. Perkembangan ini membuka peluang agar semakin banyak fungsi kecerdasan buatan dapat dijalankan langsung pada perangkat tanpa selalu bergantung pada cloud untuk setiap proses. Pembaca juga dapat membagikan pendapat mengenai perkembangan teknologi on device AI serta jenis fitur kecerdasan buatan lokal yang diharapkan semakin luas pada gadget modern.