AI Inference Engine Optimization Dorong Era On-Device AI yang Lebih Cepat dan Efisien

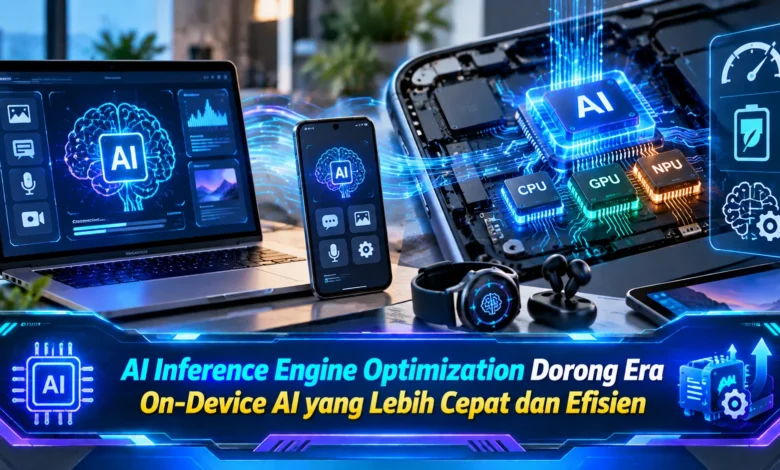
Perkembangan AI mulai bergerak semakin dekat ke perangkat pengguna melalui konsep on device AI. Smartphone, laptop, wearable, kendaraan, dan berbagai perangkat pintar kini membutuhkan kemampuan menjalankan model kecerdasan buatan secara cepat tanpa selalu bergantung pada pemrosesan cloud. AI Inference Engine Optimization menjadi bagian penting dalam perubahan tersebut karena teknologi ini membantu model memanfaatkan CPU, GPU, NPU, memori, dan sumber daya perangkat secara lebih efisien sehingga pengalaman AI lokal dapat terasa semakin responsif.
AI Inference Engine Optimization Menjadi Fondasi On Device AI
AI Inference Engine Optimization pada dasarnya bertujuan untuk membuat proses menjalankan model AI menjadi lebih efisien pada hardware yang tersedia. Setelah sebuah model selesai dilatih, perangkat perlu menjalankan proses inference setiap kali menerima input baru dan menghasilkan keluaran. Proses ini dapat membutuhkan sejumlah besar perhitungan sehingga kekuatan prosesor perlu didukung optimalisasi software yang tepat.
Dalam penerapan on device AI, efisiensi menjadi semakin penting karena perangkat harus bekerja dengan keterbatasan baterai, memori, termal, dan kemampuan komputasi. Sistem inference dapat menyesuaikan alur model, menentukan metode eksekusi, menggunakan hardware accelerator, dan mengurangi overhead yang tidak dibutuhkan. Pendekatan tersebut membuat teknologi AI lokal tidak hanya bergantung pada seberapa kuat chipset yang digunakan, tetapi juga seberapa baik software memanfaatkan kemampuan chipset tersebut.
CPU GPU dan NPU Bekerja Bersama Mempercepat AI Lokal
Sebuah perangkat dapat menggunakan berbagai unit komputasi yang masing masing mempunyai kemampuan berbeda. CPU dapat menjalankan beragam tugas dengan fleksibel, GPU unggul pada komputasi paralel, sementara NPU menyediakan akselerasi khusus untuk berbagai operasi AI. Kemampuan yang berbeda memungkinkan mesin inference membagi operasi berdasarkan kekuatan masing masing unit pemrosesan.
Pembagian workload yang tepat dapat membantu menghindari kondisi ketika seluruh proses AI dibebankan kepada satu jenis prosesor. CPU dapat menangani logika dan pekerjaan umum, GPU dapat menjalankan komputasi paralel, sementara NPU dapat digunakan untuk operasi AI yang sesuai. Mesin inference tetap harus memperhitungkan perpindahan informasi antarprosesor karena distribusi workload yang berlebihan dapat menambah overhead. Dengan pembagian yang terencana, teknologi on device AI dapat memperoleh manfaat dari berbagai accelerator tanpa mengorbankan efisiensi secara berlebihan.
Optimalisasi Graph Membantu Model AI Berjalan Lebih Ringkas
Model AI dapat direpresentasikan sebagai rangkaian operasi komputasi yang saling terhubung sehingga membentuk computational graph. Mesin inference dapat memeriksa graph untuk menemukan operasi yang dapat dioptimalkan, digabung, maupun dijalankan dengan pendekatan yang lebih efektif. Tujuan utamanya adalah mengurangi overhead tanpa mengubah fungsi penting dari model.
Operator fusion menjadi salah satu teknik yang dapat membantu dengan menggabungkan beberapa operasi yang sebelumnya dijalankan secara terpisah. Penggabungan operasi dapat menekan frekuensi transfer data sehingga prosesor tidak perlu terlalu sering mengakses memori. Apabila proses tambahan serta transfer informasi dapat ditekan, CPU, GPU, dan NPU dapat memusatkan lebih banyak sumber daya pada workload utama. Optimalisasi seperti ini membantu teknologi on device AI menghasilkan respons lebih cepat tanpa selalu membutuhkan peningkatan besar pada spesifikasi perangkat keras.
Presisi Numerik Membantu Mengurangi Beban On Device AI
Salah satu pendekatan penting dalam optimalisasi inference adalah quantization karena model kecerdasan buatan memproses sejumlah besar nilai numerik. Penggunaan presisi yang lebih rendah pada operasi yang sesuai dapat membantu menekan konsumsi memori dan kebutuhan pemrosesan. Data yang lebih ringkas juga dapat mengurangi tekanan terhadap bandwidth memori karena jumlah informasi yang harus dipindahkan menjadi lebih kecil.
Manfaat quantization dapat semakin besar ketika CPU, GPU, atau NPU memiliki dukungan terhadap format numerik yang digunakan. Namun, pengurangan presisi tetap perlu dievaluasi karena konfigurasi yang terlalu agresif dapat memengaruhi kualitas keluaran model. Mesin inference perlu menyeimbangkan kecepatan pemrosesan, ukuran model, penggunaan memori, konsumsi energi, serta ketepatan hasil. Pertimbangan tersebut penting bagi teknologi AI lokal karena perangkat harus menjalankan model secara cepat sambil mempertahankan efisiensi baterai.
Manajemen Memori dan Efisiensi Daya Menentukan Pengalaman On Device AI
Kecepatan prosesor bukan satu satunya faktor yang menentukan performa on device AI karena aliran data antara memori dan unit komputasi juga memiliki peran besar. Unit pemrosesan yang cepat tetap dapat kehilangan efisiensi ketika harus menunggu data maupun parameter tersedia. Karena itu, inference engine dapat mengoptimalkan penggunaan buffer, alokasi memori, urutan operasi, serta penggunaan kembali ruang penyimpanan sementara.
Konsumsi daya perlu dikendalikan karena aktivitas inference yang intensif dapat memberikan dampak terhadap daya tahan baterai maupun kondisi termal perangkat. Mesin inference dapat menentukan accelerator yang tepat serta mengatur beban komputasi sehingga perangkat tidak terus menerus menggunakan sumber daya maksimum. Cara tersebut membantu teknologi AI lokal diterapkan pada ponsel, komputer portabel, wearable, serta perangkat pintar yang membutuhkan keseimbangan performa dan efisiensi energi.
Penutup AI Inference Engine Optimization
AI Inference Engine Optimization menjadi salah satu fondasi penting dalam perkembangan on device AI karena model kecerdasan buatan perlu berjalan cepat dengan sumber daya perangkat yang terbatas. Distribusi pekerjaan pada CPU, GPU, dan NPU memungkinkan hardware digunakan berdasarkan kekuatannya, sementara optimalisasi graph dan penggabungan operator membantu menekan overhead. Quantization membantu menekan ukuran serta kebutuhan komputasi model, sementara optimalisasi memori mengurangi hambatan dalam perpindahan informasi. Dengan menggabungkan optimalisasi model, hardware, memori, dan daya, teknologi AI pada perangkat dapat menjadi semakin responsif sekaligus efisien. Optimalisasi yang semakin baik dapat membuat lebih banyak fitur AI dijalankan pada perangkat sehingga pemrosesan cloud tidak selalu diperlukan untuk setiap tugas. Anda dapat mengikuti perkembangan teknologi AI Inference Engine Optimization sekaligus berdiskusi mengenai kemampuan on device AI yang paling dibutuhkan pada perangkat masa depan.